·9 min lezen
Wat AI wel en niet kan bij douanedocumenten
Elke leverancier in deze markt zegt inmiddels dat zijn software je documenten leest. Dat klopt ook, tot op zekere hoogte. Dit is de eerlijke versie: wat automatisch uitlezen echt oplost, waar het aantoonbaar stukloopt, en waarom de manier waarop een systeem zijn twijfel laat zien belangrijker is dan de vraag hoe vaak het in één keer goed zit.
Wat betekent het eigenlijk als software zegt dat ze je documenten leest?
Documenten lezen is geen enkele handeling maar drie, en ze mislukken op verschillende manieren. De eerste is extractie: uit een pdf of een scan halen welke tekens er staan en welk veld ze vormen. Dat er EUR 14.320,00 staat is één ding. Dat het het factuurtotaal is en niet het subtotaal of het bedrag aan vracht, is iets anders. De tweede is classificatie: bepalen wat voor document je in handen hebt en welke rol elk blok tekst speelt. Een pakbon, een proformafactuur en een handelsfactuur lijken op elkaar, en de verschillen zitten in details die op de ene lay-out bovenaan staan en op de andere onderaan. De derde stap scheelt in de praktijk het meeste werk: de documenten naast elkaar leggen. Klopt het aantal colli op de packing list met de factuurregels. Ligt het brutogewicht op het cognossement in de buurt van dat op de packing list. Verwijst het certificaat naar hetzelfde zendingsnummer. Die derde stap is geen leesprobleem meer, het is rekenen en vergelijken, en juist daarin is een machine onvermoeibaar op een manier waarop een mens dat om vier uur 's middags niet is.
Waar werkt het uitlezen zonder morren?
Op de saaie meerderheid. Een handelsfactuur die door het ERP van een vaste leverancier is gemaakt, verstuurd als pdf met een echte tekstlaag, met elke maand dezelfde koppen op dezelfde plek, is bijna een gestructureerd bestand dat toevallig als document reist. Hetzelfde geldt voor packing lists uit een WMS en voor standaardcertificaten die een instantie in een vast sjabloon afgeeft. Het patroon achter die gevallen is niet een mooi document, maar herhaling. Bij een afzender die je elke week ziet, weet een systeem waar de incoterm staat, dat de valuta rechtsboven staat en niet naast het bedrag, dat Ref. bij deze partij het inkoopordernummer is en bij een andere partij het containernummer. Hoe vaker een afzender terugkomt, hoe minder er te raden valt. Dat is meteen ook de eerlijke grens van de belofte. Uitlezen werkt goed op het verkeer dat je al kent, en dat verkeer vult in volume het grootste deel van je dagen. Het is niet het deel waarop je aangiften vastlopen, want daar zit je tijd niet in. Je tijd zit in de uitzonderingen.
Waar loopt het aantoonbaar stuk?
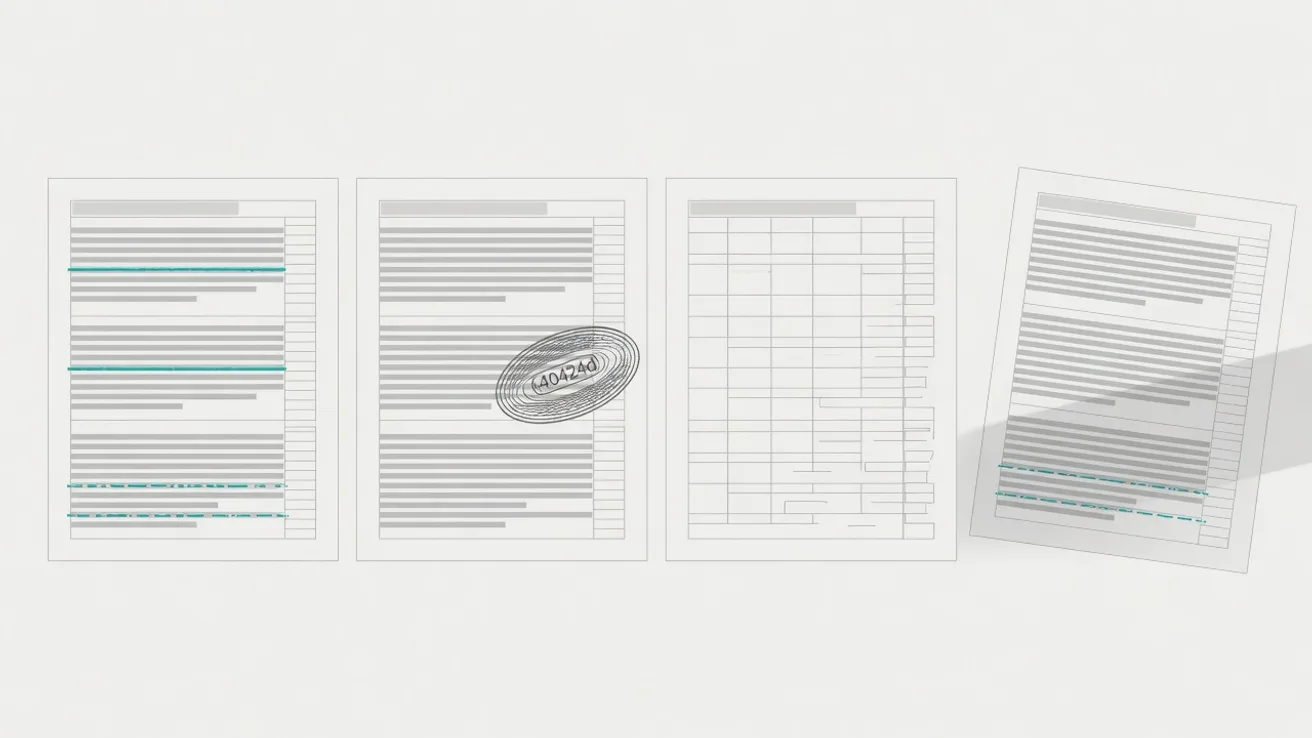
De lijst is concreet en iedereen die aangiften doet herkent hem. Handschrift, bijvoorbeeld een gewicht dat op de kade met pen is bijgeschreven, of een handtekening met een datum eronder die het certificaat pas geldig maakt. Een gestempeld document dat ooit een fax was, daarna is gekopieerd, gescand en opnieuw doorgestuurd, waarbij de stempel precies over de tekst valt die je nodig hebt. Een packing list van elf pagina's waarvan de regeltelling niet uitkomt op wat de factuur zegt. Een tabel die over een paginaovergang doorloopt, waarbij de koppen niet worden herhaald en de laatste regel van pagina drie en de eerste van pagina vier in werkelijkheid één regel zijn. Documenten in twee talen door elkaar, met een Chinese omschrijving en een Engelse eronder die niet hetzelfde zegt. En de foto: een pagina die iemand schuin met een telefoon heeft vastgelegd, met een schaduw over de rechterkolom en een vouw dwars door het bedrag. Wat deze gevallen delen is dat ze niet een beetje moeilijker zijn. Het zijn de gevallen waarin een systeem dat hoe dan ook een antwoord moet geven, iets plausibels invult. Een leeg veld ziet iedereen. Een netjes ingevuld verkeerd veld niet.
Waarom een betrouwbaarheidsscore niet hetzelfde is als goed
Een score zegt hoe goed een antwoord past bij de patronen die het model eerder heeft gezien. Dat is een andere vraag dan of het antwoord waar is. Een keurig gedrukte factuur waarop een bedrag in de verkeerde kolom staat, levert een hoge score op precies dat verkeerde bedrag, want de vorm klopt. De score meet de vorm, niet de werkelijkheid. Daar zit de asymmetrie waar je omheen moet ontwerpen. Een veld dat als onzeker is gemarkeerd kost je twintig seconden en gaat goed. Een veld dat met hoge zekerheid fout is, gaat het dossier in, langs de collega die erop vertrouwt, de aangifte in en uiteindelijk naar de Douane. Fout met zekerheid is duurder dan onzeker. De interessante vraag is daarom niet hoe vaak een systeem het goed heeft, maar of het weet wanneer het het niet weet, en wat het dan doet. Een lezer die bij twijfel liever niets invult en het veld openlaat, is bruikbaarder dan een lezer die altijd iets invult. Het eerste kost een handeling. Het tweede kost een correctie achteraf, en soms meer dan dat.
Waarom elk veld een bronlabel moet dragen
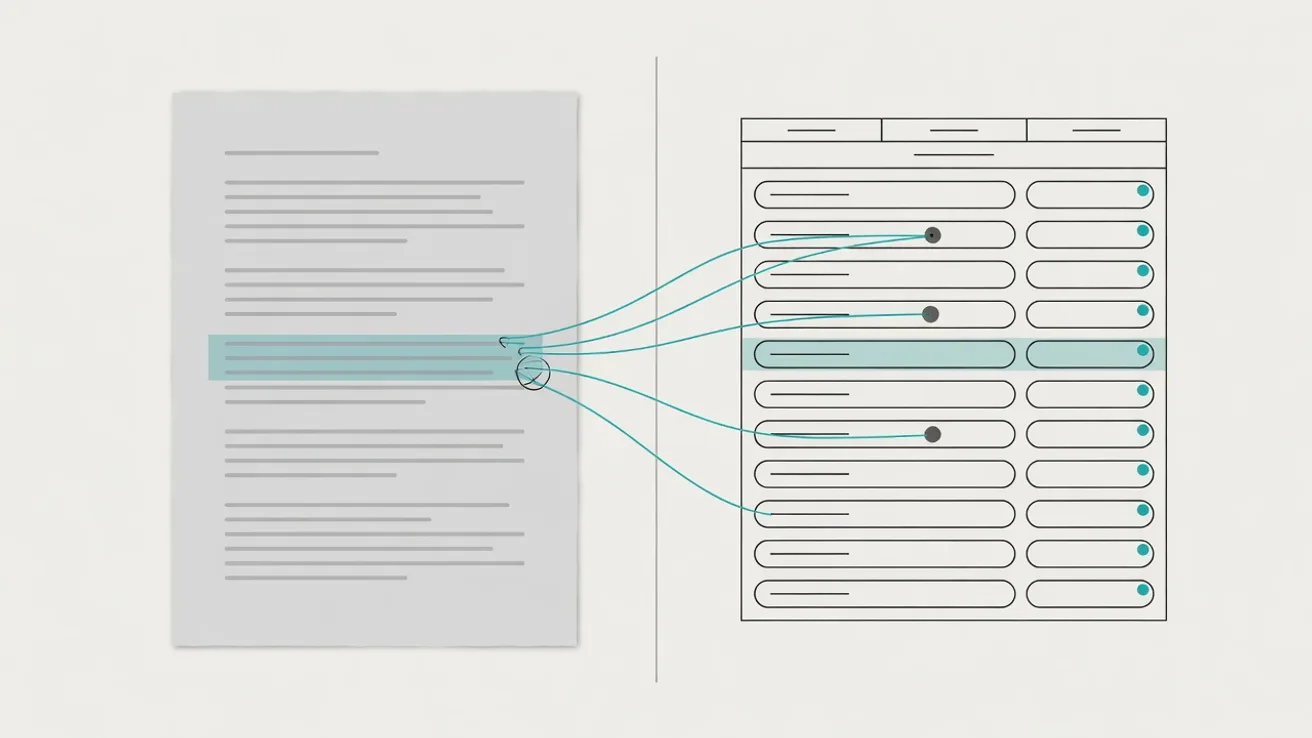
Zodra je accepteert dat een systeem soms fout zit, is de vraag niet meer hoe je fouten uitsluit maar hoe je ze binnen seconden vindt. Dat is een ontwerpeis en geen extraatje. Elk uitgelezen veld draagt een label terug naar het document waar het vandaan komt en naar de plek op de pagina, zodat één klik het fragment naast het veld zet. Het verschil in het dagelijkse werk is groot. Zonder bronlabel controleer je een factuurtotaal door het document op te zoeken, de juiste pagina te vinden, met je ogen te zoeken en het bedrag te vergelijken. Met bronlabel staat de regel waar de waarde vandaan komt naast het veld, en bevestig je of je corrigeert. Controleren wordt kijken in plaats van overtypen. Diezelfde keten heb je later nog nodig. Bij een controle achteraf moet je kunnen laten zien waar een aangegeven douanewaarde vandaan komt: welk factuurbedrag, welke vrachtkosten tot de plaats van binnenkomst in de Unie, welke wisselkoers op welk moment. Een systeem dat wel het getal bewaart maar niet de herkomst, laat je in de steek op precies het moment waarop de vraag gesteld wordt.
Waarom indelen geen uitleesprobleem is
Extractie en indelen worden vaak in één adem genoemd en het zijn verschillende dingen. Extractie is een feitelijke vraag: staat dit hier. Indelen is een juridisch oordeel. Je past de indelingsregels toe op een goed, je weegt de aard, de samenstelling en de functie, je kiest tussen posten die elkaar uitsluiten, en je komt via een hs-code die de eerste zes cijfers vastlegt uit op de volledige code waar het tarief aan hangt. Aan dat oordeel hangt aansprakelijkheid. De code bepaalt het tarief, een eventuele preferentie, of er antidumpingheffing geldt en welke verboden en beperkingen meekomen. Zit hij fout, dan volgt navordering, en bij indirecte vertegenwoordiging komt die bij jou terecht. Wie zekerheid wil, vraagt een BTI aan, en dat traject bestaat juist omdat het antwoord niet uit het document zelf te lezen valt. Software mag hier helpen door het zoekgebied te verkleinen: de omschrijving naast eerdere zendingen leggen, de code voorstellen die je bij deze afzender en dit artikel eerder hebt gebruikt, en waarschuwen wanneer een voorgestelde code maatregelen meebrengt die het dossier niet dekt. Voorstellen en onderbouwen. Het besluit blijft bij de aangever.
Waar is de mens in de lus dan wel voor?
Niet om alles opnieuw na te lopen. Wie elk veld nog een keer controleert, heeft de tijdwinst weggegeven en houdt een extra scherm over. De mens is er voor de plekken waar het oordeel zit, en een goed ingerichte lezer duwt hem daar naartoe. Dat zijn drie dingen. Ten eerste de velden die het systeem zelf niet rond krijgt, met het brondocument ernaast, zodat de beslissing seconden kost. Ten tweede de tegenspraak tussen documenten: de packing list met twaalf regels tegen een factuur met elf, de omschrijving op het certificaat die een andere soort noemt dan de factuur. Een machine kan dat verschil aanwijzen, maar niet beslissen welk document gelijk heeft, want dat vraagt een telefoontje naar de afzender. Ten derde het oordeel dat bij de aangever hoort: de indeling, de douanewaarde bij een ongebruikelijke prijsafspraak, de vraag of een oorsprongsbewijs bij deze goederenstroom past. Dat is precies het werk waarvoor je een declarant in dienst hebt. De winst zit niet in het vervangen van dat oordeel, maar erin dat het niet langer verdrinkt in het overtypen van gegevens die al ergens digitaal bestaan, ook bij een doodgewone invoeraangifte.